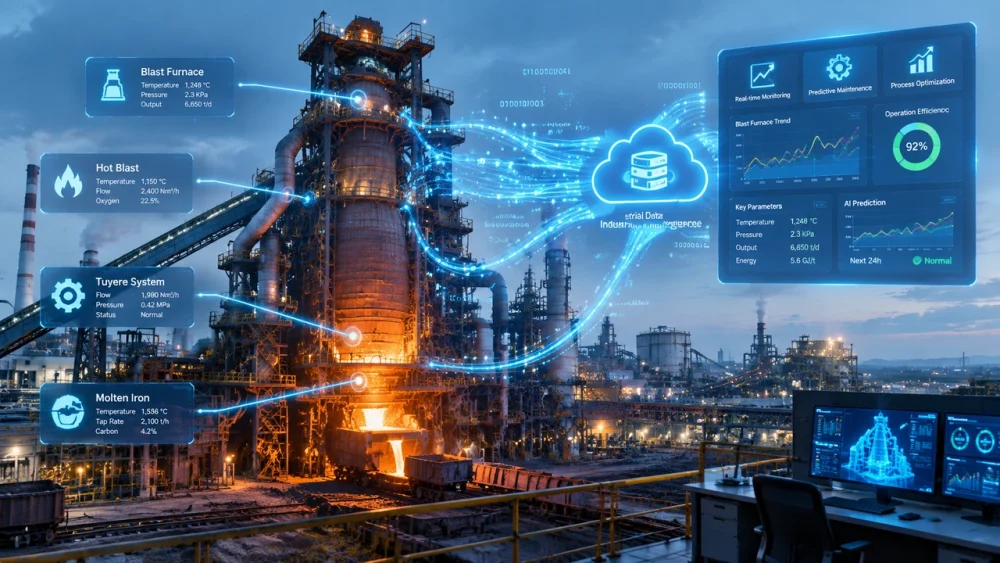

市场监管总局(国家标准委)近日正式发布首批针对钢铁行业大模型建设的三项国家标准化指导性技术文件:《人工智能 钢铁行业应用场景分类指南》(GB/Z 224—2026)、《人工智能 钢铁大模型数据集技术要求》(GB/Z 231—2026)以及《人工智能 钢铁大模型服务能力成熟度评估》(GB/Z 241—2026)。该批标准由中国钢研、宝武、宝信软件等产学研用50余家核心单位联合编制,首次确立了钢铁垂直领域大模型从场景规划、数据治理到服务成熟度评估的标准化技术闭环。
长期以来,传统重工制造企业在推进工业AI与大模型应用过程中,普遍面临非标定制成本高、OT与IT数据融合质量差、供应商技术交付能力难以量化验收等痛点。首批三项标准的出台,旨在推动钢铁行业人工智能应用由分散的单点“试验验证”走向规范化的“规模落地”,为钢铁企业CIO、数字化负责人及工业软件供应商提供了清晰的技术对齐底座。
三项标准构筑工业AI闭环底座
三项指导性技术文件各司其职,覆盖了大模型落地的前期选型、中期工程治理与后期验收全生命周期:
| 标准编号 | 标准名称 | 核心技术范围与规范重点 |
|---|---|---|
| GB/Z 224—2026 | 《人工智能 钢铁行业应用场景分类指南》 | 覆盖研发设计、工序管控、运营管理、经营管理和产业生态五大维度,规范典型长流程工序中的大模型业务场景定义。 |
| GB/Z 231—2026 | 《人工智能 钢铁大模型数据集技术要求》 | 确立垂直领域数据集结构,规范数据原始汇聚、清洗治理、知识融合、样本成型与数据安全的全流程工程要求。 |
| GB/Z 241—2026 | 《人工智能 钢铁大模型服务能力成熟度评估》 | 搭建大模型工业服务能力框架,提供量化评估指标、成熟度分级规则与综合评估方法。 |
明确重工制造场景与数据治理边界
在场景分类层面,《应用场景分类指南》聚焦钢铁长流程企业复杂的工艺链条,按业务场景层级明确了技术落地点。此举能够帮助重工制造企业在立项阶段精准识别具备投产价值的业务痛点,避免将通用大模型的能力泛化套用到高危、强机理的生产控制环节,从而防范非标定制和无效试错风险。
在数据工程层面,《数据集技术要求》直击工业数据碎片化和质量不可控的顽疾。针对钢铁企业多模态数据混杂、OT时序数据与企业管理知识壁垒高的特征,该标准规范了从底层原始数据抽取,到清洗治理、专业知识图谱与行业机理融合,再到最终下游样本集封装的技术路径,并强制要求嵌入数据安全机制,确保高质量垂直训练语料与微调数据的可用性与合规性。
在验收评估层面,《服务能力成熟度评估》为工业软件与AI供应商的技术服务能力建立了可度量的坐标系。通过分级评估规则,企业在数字化采购、招投标及PoC(概念验证)阶段,可摆脱过往依赖通用基准榜单或单一准确率断言的粗放模式,转向以工业级鲁棒性、场景适应度和服务可维护性为核心的成熟度考核。
传统重工业落地工业AI的实施路径
结合新发布的国家标准体系,重工制造企业在开展大模型工程化选型与系统建设时,可重点从以下三个方向推进布局:
- 对照分类指南收敛试点场景:围绕工序管控与运营优化等实际收益明显的场景开展需求梳理,优先落地知识密集、规则明确的业务环节,避免贪大求全造成项目延宕。
- 依循数据规范沉淀行业机理语料:依托标准中关于知识融合与样本成型的指标要求,对工厂高炉、转炉、轧钢等设备机理和现场运行规程进行标准化文本与特征处理,将离散的现场经验沉淀为高质量专有知识资产。
- 建立基于成熟度指标的供应商准入机制:在引入外部大模型技术方案时,参考成熟度评估体系设立分段验收与持续服务指标,将大模型输出的工业适用性与运维保障能力纳入采购核心约束。